
AI简报(9月11日):DeepSeek V4.1 Flash拿到GPT-6 Astra 98%的分数;Anthropic报告指控国内实验室“蒸馏” Claude
 前沿资讯
1789117550更新
 0
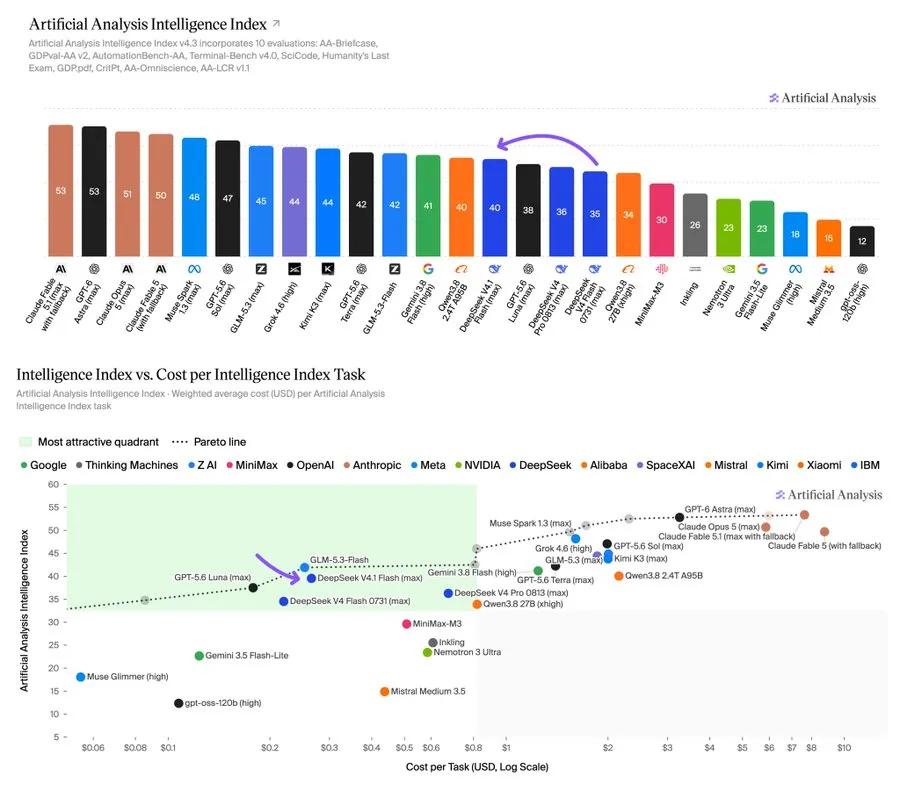
【1】Artificial Analysis 评测:DeepSeek V4.1 Flash 以 552B 参数超越 1.6T 的 V4 Pro,成本只要四分之一
摘要:Artificial Analysis 发布了对 DeepSeek V4.1 Flash 的独立评测,结果显示这款只有 552B 参数的模型,智能指数得分 40 分,直接超越了自家 1.6T 参数的旗舰 V4 Pro 0813,成为 DeepSeek 新的旗舰模型。更夸张的是成本,V4.1 Flash 每个 Token 的价格大约只有 V4 Pro 的四分之一。由于模型输出比较啰嗦,它在“智能 vs 成本”曲线上差一点就摸到了最优边界。
具体数据方面,V4.1 Flash 采用了全新的因果编码器-解码器架构,输入只激活 8B 参数,输出激活 16B 参数,总参数量在不同口径下有 552B 和 763B 两种说法,许可证为 MIT。第一方 API 定价为输入每百万 Token 0.30 美元,输出 1.20 美元,缓存输入只要 0.006 美元,折扣高达 98%。闲时价格再打五折。整体比 V4 Flash 0731 便宜约 20%,比 V4 Pro 0813 便宜约 4 倍,同时性能还更高。
能力提升主要集中在智能体任务和长上下文推理上。Terminal-Bench v4.0 得分 27%,是上一代的两倍多。GDPval-AA v2 提升了 164 个 Elo 点,从 1468 涨到 1632,超过了 Kimi K3 的 1584。AA-LCR v1.1 拿到 84%,和 GPT-5.6 Sol、Gemini 3.8 Flash 持平。上下文窗口 100 万 Token,支持文本和图像输入,非常适合长文档和大型代码仓库任务。在 AutomationBench-AA 上,它以 69% 的得分拿到第一,和 GPT-6 Astra 持平,略高于 Grok 4.6 的 67%,比自家前代提升了 15 个百分点。这个基准覆盖 39 个 SaaS 应用里的 657 个智能体任务,衡量模型能否在不触发安全护栏的前提下完成目标。
不过 V4.1 Flash 有个明显特点:非常啰嗦。每个智能指数任务平均消耗 8.9 万个 Token,比 GLM-5.3 多 25%,比 V4 Pro 多 62%,甚至超过 Fable 5.1 和 Claude Opus 5 这些前沿模型。但因为单价足够低,每个任务的实际成本仍然只有 0.27 美元,比 GLM-5.3 和 Kimi K3 便宜约 7 倍,比 V4 Pro 便宜约 2.5 倍。知识可靠性方面,AA-Omniscience 提升了 9 分到 -5.3,准确率从 40% 升到 46%,但非幻觉率从 8% 降到了 4%。
链接:https://artificialanalysis.ai/models/deepseek-v4-1-flash
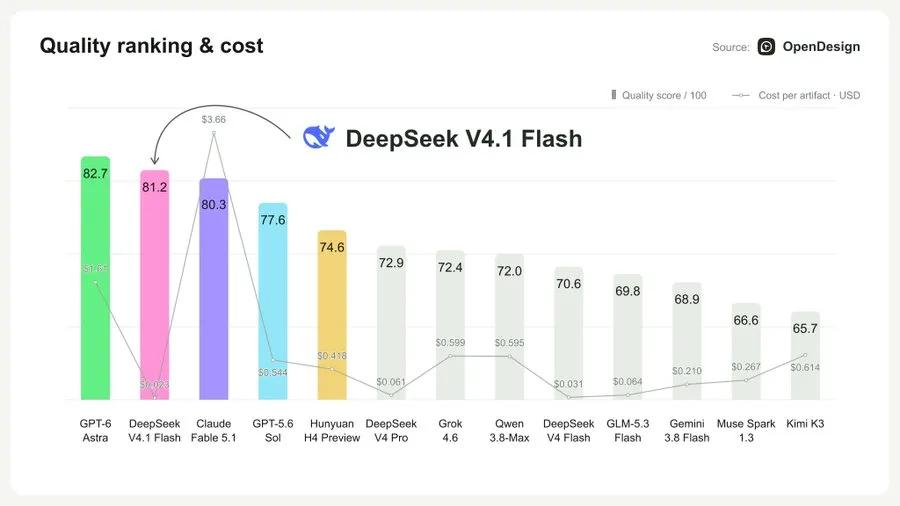
【2】OpenDesign 实测:DeepSeek V4.1 Flash 拿到 GPT-6 Astra 98% 的分数,成本只要 1.4%
摘要:OpenDesign 发现,大多数用户真正关心的不是模型极限有多强,而是“做日常设计活该选哪个模型”,于是搭建了 OpenDesign Arena 来回答这个问题。
结果相当炸裂:DeepSeek V4.1 Flash 在真实设计任务中拿到了 GPT-6 Astra 98% 的分数,而成本只有后者的 1.4%。具体来看,生成一件作品的平均耗时和花费分别是:DeepSeek V4.1 Flash 用 5.3 分钟、0.023 美元;GPT-6 Astra 用 11.1 分钟、1.61 美元;Claude Fable 5.1 用 12.8 分钟、3.66 美元。也就是说,DeepSeek 的速度不到 Astra 或 Claude 的一半,成本大约是 Astra 的七十分之一。在细分任务中,DeepSeek 在网页应用设计排第 3(82.4 分),移动应用第 5(82.5 分),桌面应用并列第 3(84.4 分),网站和落地页第 4(79.3 分),仪表盘和管理后台第 10(76.1 分)。在落地页设计上它甚至超过了 Astra,但在仪表盘类任务上稍逊一筹。
OpenDesign 特别指出,11 个模型在这套真实设计基准上得分都比 DeepSeek V4.1 Flash 低,而且成本更高,只有 GPT-6 Astra 得分更高。他们由此抛出一个问题:开放模型是不是正在超越闭源模型?
链接:https://open-design.ai/zh/llm-arena-for-design/
【3】Anthropic 报告指控 7 家国内实验室“蒸馏” Claude
摘要:Anthropic 发布了一份详细的威胁情报报告,披露了多起针对 Claude 的滥用行为。报告指控阿里巴巴提取了超过 1.51 亿条 Claude 对话用于帮助训练 Qwen,Kimi 在用户不知情的情况下将部分请求秘密路由到 Claude,DeepSeek 也有类似行为。
链接:https://www.anthropic.com/threat-intelligence-report-september-2026
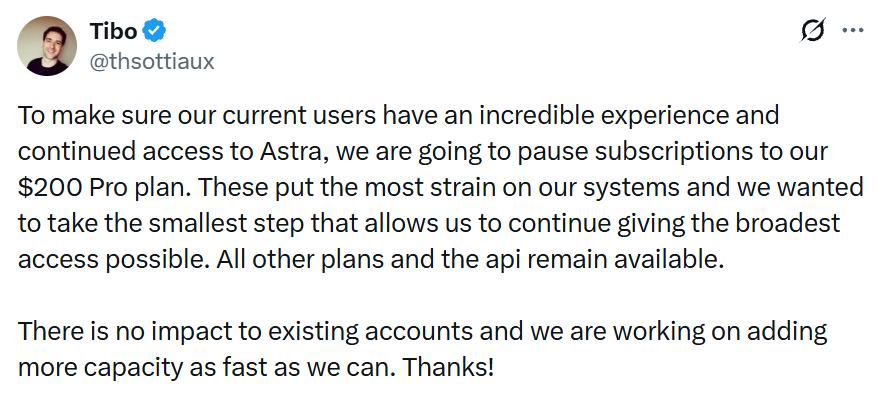
【4】OpenAI 暂停 200 美元 Pro 订阅新用户注册,称 Astra 需求前所未有,现有账户和 API 不受影响
摘要:OpenAI 的 Tibo 宣布暂停 200 美元 Pro 计划的新订阅,原因是 Astra 需求前所未有、对系统造成最大压力,此举是为了给现有用户保留最好的体验和持续的 Astra 访问权限,所有其他计划和 API 仍正常开放。现有账户不受影响,团队正在尽快扩充容量。
前两天 Tibo 就曾表示,Astra 的需求量前所未有,公司正在拉满所有能用的杠杆来支撑需求,虽然过去也经历过非常陡峭的增长,但这次的情况完全没见过。他强调优先级永远是保障现有用户的服务质量。
链接:https://x.com/thsottiaux/status/2098113585683808624
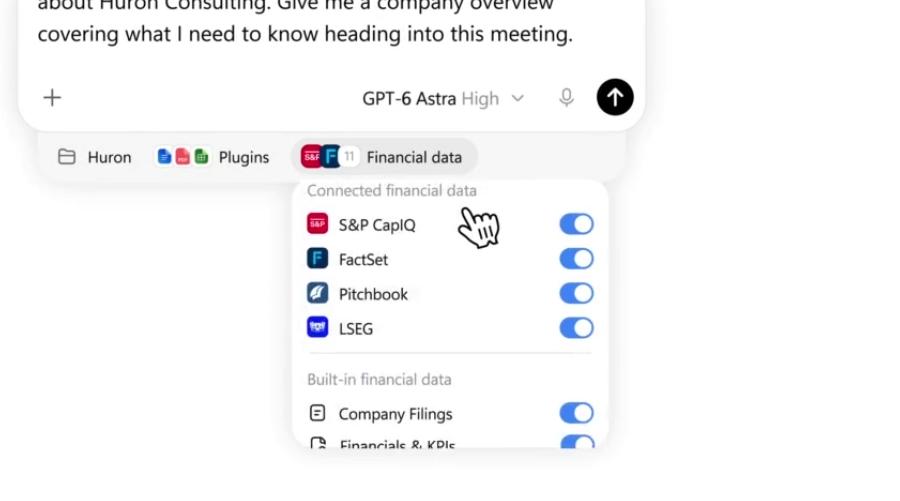
【5】OpenAI 推出 ChatGPT for Financial Services:内置专业金融数据,瞄准华尔街初级银行家的研究、建模和推介材料工作
OpenAI正式发布了 ChatGPT for Financial Services,一个专为投资银行和股票研究团队定制的金融版 ChatGPT。
这是 ChatGPT Work 企业版的金融行业定制版,由 OpenAI 与摩根士丹利(Morgan Stanley)和 Evercore 等投行共同设计开发,集成了 GPT-6 Astra 的前沿推理能力。简单说,就是让 AI 替金融从业者做那些最耗时的基础活儿:研究公司、分析财务数据、制作推介材料(Pitchbook)和估值模型。
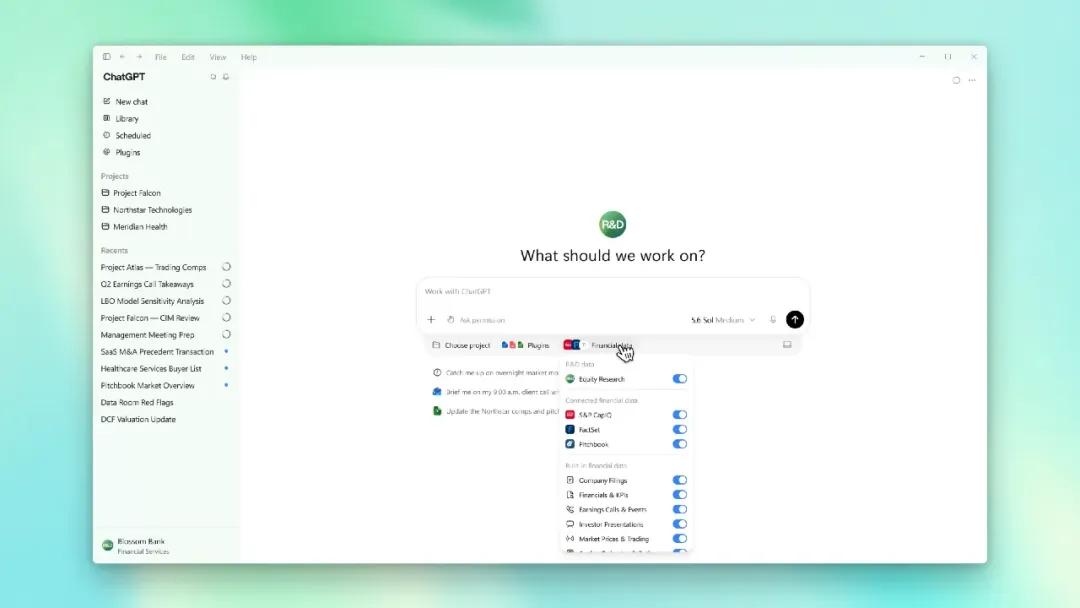
具体能力包括:
原生金融数据接入:内置 Daloopa、PitchBook、LSEG News、Crunchbase 等专业金融数据源,无需自己配置连接器,数据涵盖财报电话会记录、财务报表、公司基本面、私营企业信息等。
溯源引用:每一项数据和结论都能追溯到原始文件的具体表格或段落,方便审核。
企业模板输出:管理员可以上传公司自己的 Excel、Word、PPT 模板,分析结果直接按公司格式输出。
现有订阅打通:正在与 S&P Capital IQ、LSEG、MSCI、穆迪等合作,用户通过 ChatGPT 登录即可访问自己机构已订阅的数据。
这标志着 OpenAI 正式进军华尔街传统上由初级银行家(分析师和助理) 承担的工作领域。这些刚毕业的大学生长期以来负责研究交易、制作推介材料,每周工作 100 小时是常态。
OpenAI 产品副总裁 Nick Turley 将其定位为“效率工具”:“我们实际上是在教 ChatGPT 像分析师一样研究,并像分析师一样为自己的结论提供依据”。
但这也引发了根本性问题:高盛高管 Chris Churchman 曾警告,自动化那些原本用于训练初级银行家的任务,可能导致下一代金融从业者出现“认知萎缩”。
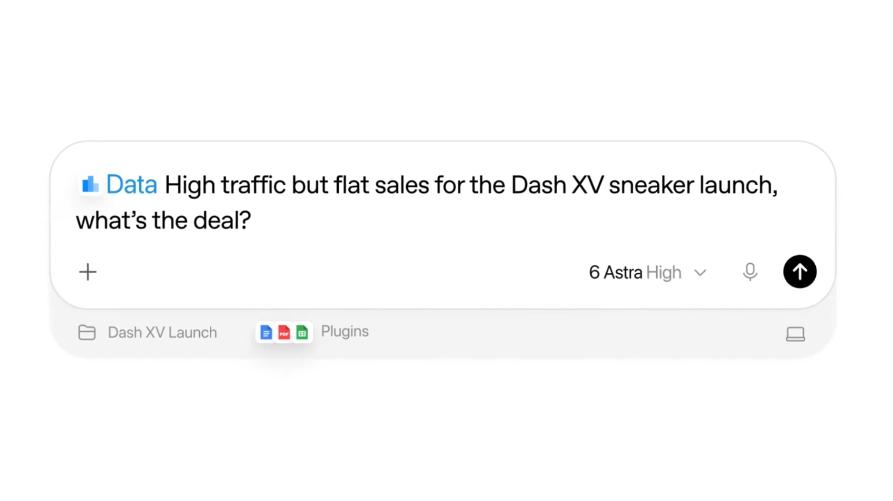
【6】OpenAI 在 ChatGPT Work 里塞了个“数据问答机器人”:用大白话问,它自己去翻 Snowflake、BigQuery 和 BI 工具,把答案、图表和下一步行动都给你端上来
摘要:简单说,这是OpenAI给企业员工配的一个“数据问答机器人”。以前想知道“为什么上周销售额跌了”,得等数据团队跑报告,现在直接在ChatGPT里用大白话问,它自己去翻公司的数据库和分析工具,把答案和图表端到你面前。
它干三件事,按顺序来:
第一,自己去翻数据。 它连着公司已经批准的数据库,比如 Snowflake、Databricks、BigQuery、Redshift,也能读 Google Drive 和 SharePoint 里的文件。你不用懂 SQL,也不用知道数据存在哪张表里。
第二,自己调查原因。 它不是只给你一个数字。你问“为什么流失率涨了”,它会自己拆解问题,对比不同时间段,找出可能的原因,然后把证据摆出来让你核对。
第三,把分析变成能用的东西。 结果可以直接生成一张互动式仪表盘,团队可以一起看、一起改、随时刷新。它还能在你批准后,直接去 Tableau、Power BI 这些你们已经在用的工具里更新图表。
这个 Data agent 不是凭空造出来的。OpenAI 自己内部先用了很久。他们之前有个问题:员工想问数据,得排队等数据团队。后来他们自己造了个内部工具,覆盖了 600PB 的数据、7 万个数据集,服务了超过 3500 名员工。现在 OpenAI 几乎所有的产品团队、超过三分之二的销售团队,都是自己在 ChatGPT Work 里用这个工具查数据,不等报告了。
所以这次发布,等于把内部已经跑通的东西,拿出来给所有企业用。
【7】OpenAI 发布 GPT-Live-1:边听边说、随时打断,语音对话终于像真人聊天了
摘要:OpenAI 在 API 中正式上线 GPT-Live-1,把 ChatGPT 那种自然的全双工对话体验开放给开发者。和传统的语音智能体不同,它不再把语音转文字、推理、文字转语音三个环节拼在一起,而是用单个模型同时处理“听”和“说”。这个架构变化带来的直接好处是,中间交接的延迟和上下文丢失问题被大幅削减。
功能层面,GPT-Live-1 有几个关键升级。第一是打断处理,用户可以随时插话、改变话题,甚至笑一声或者补充一个刚想到的细节,模型都能实时响应,不用等它把话讲完。第二是推理和工具调用的委托,GPT-Live-1 本身负责语音层,可以把复杂的推理和操作交给后端文本模型处理,比如日常高频任务用 Luna 这类轻量模型,复杂的客户问题用 Astra 这类旗舰模型,开发者在速度、成本和推理深度之间灵活搭配。第三是个性化控制,开发者可以通过系统提示词设定语气、语速和对话风格,模型还能模仿说话者的情绪和节奏。第四是静默上下文管理和背景噪音处理,咖啡厅的嘈杂人声、街道噪音都不会打断对话。第五是长会话可靠性,在长时间交互中保持上下文记忆和对话质量。第六是电话支持,可以直接部署到电话场景,比如餐厅预订或客服热线。
在评测数据上,GPT-Live-1 在 Full Duplex Bench 上的表现比 GPT-Realtime-2.1 提升了 30 个百分点。搭配 GPT-6 Astra 中等推理强度后,它在 Tau3 语音智能体基准上排到第一,得分 86.2%,远超前代的 45.7% 和 42.4%。在 Tau Banking 语音知识测试中拿到 32.0%,同样大幅领先。Artificial Analysis 的对话动态评分上,GPT-Live-1 拿到 97.3%,优于前代的 95.7% 和 95.3%。轮次切换延迟从 1.41 秒压到了 0.798 秒。工具调用场景下的通过率达到 87.0%,前代只有 60.0% 和 58.0%。
语音选项方面,OpenAI 这次从少量实时语音扩展到了覆盖更多口音、方言和语言的丰富选择,包括 Quartz、Ripple、Vesper、Willow、Stone、Gleam、Meridian、Bossa、Tempo、Beacon、Delta、Cinder 等。定价为前端语音层每分钟 0.05 美元,后端模型根据开发者自己选择的方案计费。企业用户还可以通过 OpenAI Presence 来部署更完整的语音工作流,支持回答问题、解决问题、调用公司系统、执行已批准的操作,必要时还能转接人工。
链接:https://openai.com/index/introducing-gpt-live-1-in-the-api/
 豫公网安备41010702003375号