
SpaceXAI发布Grok 4.7:编程能力大幅跃升,智能指数46分冲进全球前四
 前沿资讯
1790063305更新
 0
SpaceXAI 正式发布 Grok 4.7,号称是目前最强的编程和知识工作模型,速度翻倍、价格只有同类一半。
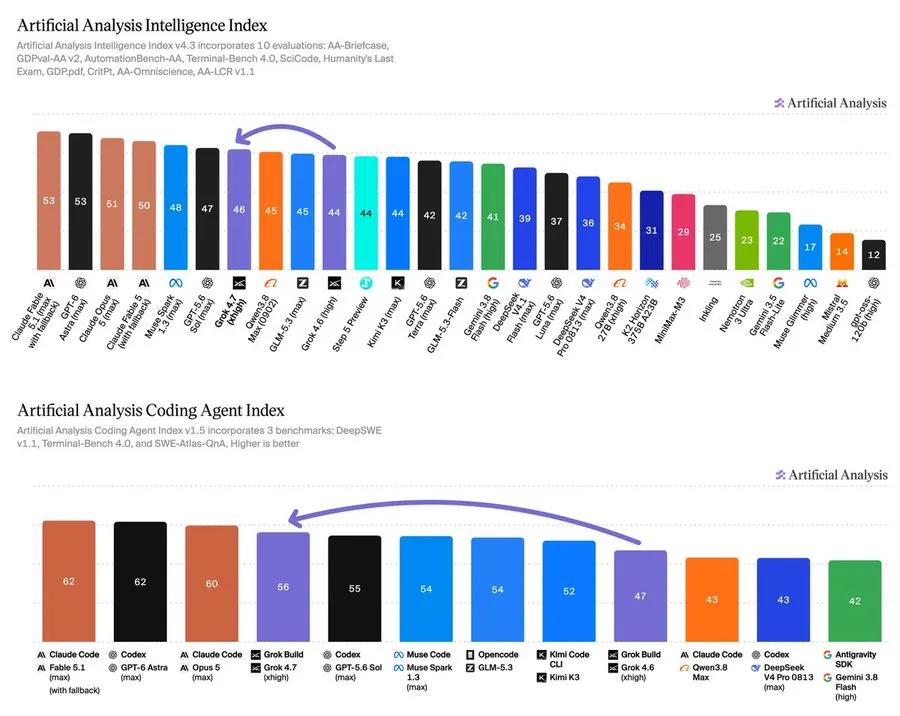
在 Artificial Analysis 智能指数上拿到 46 分,比上一代提升 2 分,直接把 SpaceXAI 带进全球前四大 AI 实验室;评测采用最高推理强度。
知识工作:一口涨了 111 分
这次提升集中在智能体知识工作和编程两个方向。
在 AA-Briefcase 这个长周期智能体知识工作基准上,Grok 4.7 比前代暴涨111 个 Elo 点、拿到 1657,直接跻身 Claude Opus 5 和 Claude Fable 5.1 所在的前沿阵营。在 GDPval-AA 上拿到 1695 Elo,比前代高出 90 分。
编程:47 涨到 56,官方智能体立功了
编程方面进步更明显。搭配自研的 Grok Build智能体,编程智能体指数从 47 分涨到 56 分,几项关键基准全线拉升:
| 基准 | 前代 | 现在 |
|---|---|---|
| DeepSWE v1.1 | 65% | 73% |
| Terminal-Bench 4.0 | 18% | 33% |
| SWE-Atlas-QnA | 58% | 63% |
凭借这组成绩,它在所有使用原生框架的模型里排到第四,仅次于 Claude Fable 5.1、GPT-6 Astra 和 Claude Opus 5。
提升的代价:输出明显变贵了
Grok 4.7 的 Token 消耗明显变高,每个智能指数任务平均输出约8.1 万个 Token,是前代的 2.25 倍,更是 GPT-6 Astra 的近 3 倍。
上下文窗口保持 50 万 Token,定价为输入每百万 Token 2 美元、输出 6 美元、缓存命中降到 0.5 美元,与前代一致;另外还提供一个输出速度翻倍、价格也翻倍的快速版本。
不过,榜单亮眼不代表实战能打。
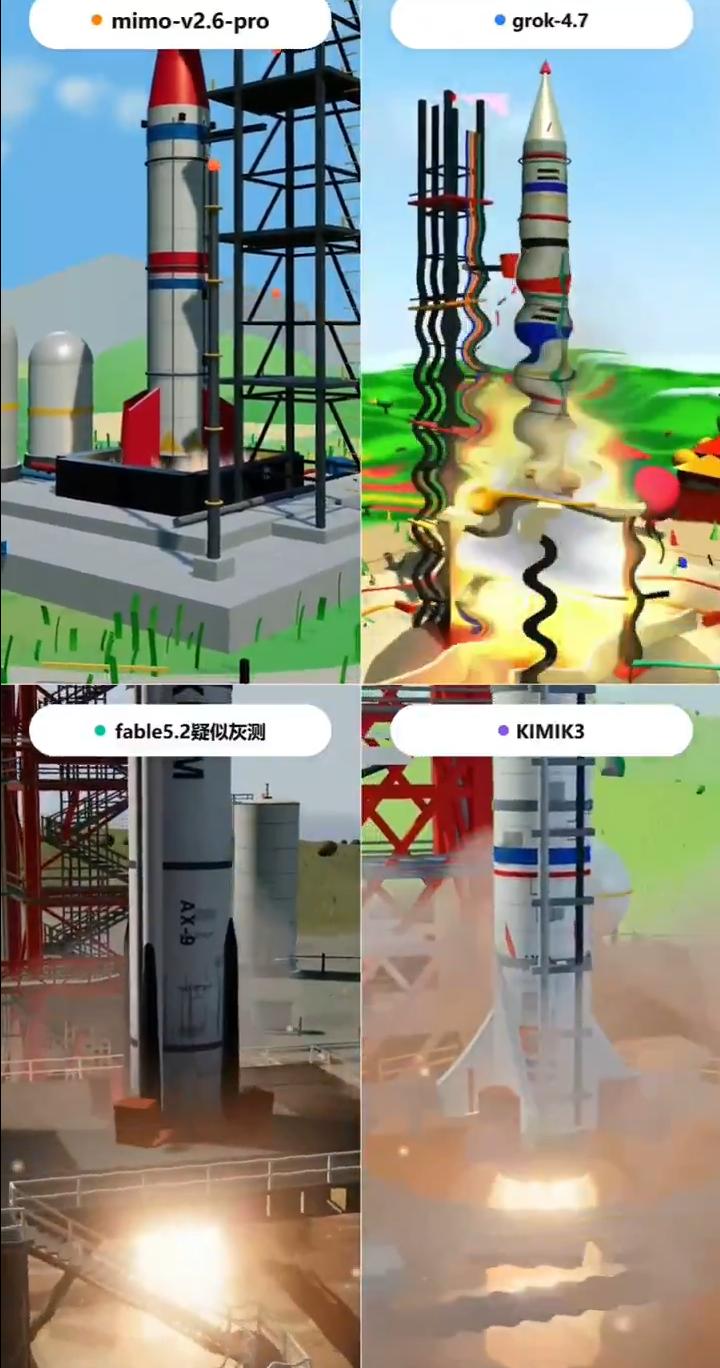
有用户做了一组 Three.js 单文件 3D 发射场生成对比,结果相当扎心。
同样的提示词,MiMo-V2.6 Pro 一次性交付了完整发射场,发射塔、储罐、绿地、红鼻子火箭、尾部火焰全部到位,看起来真像要发射。Kimi K3 也做出了多级火箭、尾翼和橙色环带,虽然没有完整发射场但至少像火箭。
而 Grok 4.7 思考时间极长,整个空间结构却崩了,最后只吐出一根喷火的扭曲柱子,没有发射塔、没有储罐、连地面都没有,前端表现直接翻车。发帖人调侃说,别人都在建发射台,Grok 4.7 只配当对比实验里的反面教材。
模型即日起在 Cursor、Grok Build、Grok API 以及第三方编程框架和云平台上线。
 豫公网安备41010702003375号